Kategorier
Forskning Supercomputing

Danske universiteter lancerer uafhængig AI-platform til forskning og innovation: UCloud AI

UCloud AI samler avancerede sprogmodeller, national supercomputerkraft og sikker digital infrastruktur på én platform. Den nye platform er udviklet som en offentlig service frem for et kommercielt AI-produkt og skal gøre kunstig intelligens mere tilgængelig for forskere i hele Danmark.

Odense/Aarhus/Aalborg, 14. september 2026

Kunstig intelligens skaber nye muligheder inden for forskning, erhvervsliv og den offentlige sektor. Men det kræver ofte adgang til stor computerkraft, specialiseret ekspertise og løsninger, der kan håndtere data sikkert, hvis mulighederne skal udnyttes. Med lanceringen af UCloud AI samler de danske universiteter nu disse muligheder i en ny suveræn AI-platform.

UCloud AI er udviklet af Syddansk Universitet og integreret i den nationale forskningsplatform UCloud. Platformen kører på AI-supercomputeren BITTEN, der er placeret i Sønderborg. Her får brugerne adgang til avancerede sprogmodeller gennem et allerede kendt digitalt miljø, hvor de kan arbejde med AI side om side med deres eksisterende data, lagerplads og applikationer. Tjenesten bygger videre på det eksisterende samarbejde mellem SDU, Aarhus Universitet og Aalborg Universitet i Interactive HPC-konsortiet.

Platformen er udviklet til at understøtte en bred vifte af brugere og formål. Ved lanceringen får forskere og studerende ved Danmarks otte universiteter adgang til tjenesten via deres eksisterende universitetslogin. Inden længe vil virksomheder, organisationer og andre, der har behov for en sikker og tilgængelig måde at bruge teknologien på, også kunne få adgang til tjenesten.

”Vores ambition er at gøre avanceret AI tilgængelig for alle, der kan have gavn af teknologien – ikke kun dem, der har den tekniske ekspertise eller ressourcerne til at opbygge deres egen infrastruktur. Med UCloud AI samler vi stærke modeller, computerressourcer og et sikkert digitalt miljø ét sted. Det er en offentlig service bygget på dansk infrastruktur, hvor brugerne kan arbejde med AI uden at give afkald på kontrollen over deres data, eller deres intellektuelle ejendomsret og samtidig til en markant lavere pris end hos andre udbydere. Vi tror på, at det kan åbne helt nye muligheder for forskning, innovation og samfundet som helhed,” siger Claudio Pica, professor og leder af SDU eScience Center ved Syddansk Universitet.

SDU vil desuden samarbejde med Danish Centre for AI Innovation (DCAI), som ejer og driver Gefion, Danmarks nationale AI-supercomputer. Forskere med projekter, der har behov for at skalere eller har særlige krav til computerkraft, vil også kunne få adgang til Gefion gennem UCloud AI. Samarbejdet peger mod en fremtid, hvor flere supercomputerinfrastrukturer kan tilgås gennem én samlet platform. Det giver forskerne større fleksibilitet og skaber nye muligheder for ambitiøs forskning og innovation.

 AI-infrastruktur bygget til følsomt arbejde

UCloud AI er open source og fungerer inden for UClouds eksisterende sikkerhedsrammer og databehandleraftaler. AI-behandlingen foregår i Danmark, hvilket understøtter forskning og organisatorisk arbejde med følsomme data og samtidig reducerer afhængigheden af eksterne kommercielle udbydere. Platformen samler AI-modeller, data, lagerplads og HPC-ressourcer i ét miljø og tilbyder både et chatinterface og en OpenAI-kompatibel API til udvikling af mere avancerede applikationer.

”AI er et strategisk fokusområde på tværs af alle danske universiteter, og hvis vi fortsat skal være i front inden for forskning og innovation, har vi også brug for den suveræne infrastruktur, der kan understøtte den ambition. UCloud AI giver forskerne adgang til avanceret AI, samtidig med at kontrollen over data og kritisk infrastruktur bevares i Danmark. Det styrker vores mulighed for at udvikle viden og teknologi på vores egne præmisser og i sidste ende skabe værdi for samfundet som helhed,” siger Jens Ringsmose, rektor for Syddansk Universitet og forperson for Danske Universiteter.

”Sikker og tilgængelig AI-infrastruktur bliver stadig vigtigere for dansk forskning. Set fra Aalborg Universitets perspektiv er UCloud AI en interessant tilføjelse til den nationale forskningsinfrastruktur og et godt eksempel på, hvordan eksisterende samarbejde kan give forskere adgang til nye muligheder,” siger Thomas Bak, dekan for Det Tekniske Fakultet for IT og Design ved Aalborg Universitet.

UClouds brugere er klar til den nye platform

På Aarhus Universitet har forskere allerede brugt UCloud til at undersøge, hvordan sprogmodeller reagerer på mere end 3.000 dilemmaer fra radioprogrammet Sara & Monopolet, og hvor tæt deres råd ligger på svarene fra programmets menneskelige panel. Et andet eksempel er Lex.llm et samarbejde med Lex.dk (Danmarks nationalleksikon), der undersøger, hvordan generativ AI kan kombineres med kvalitetssikret dansk viden.

UCloud AI vil gøre det lettere for projekter som disse at få adgang til modeller og udvikle applikationer uden selv at skulle etablere den underliggende modelinfrastruktur.

Platformen vil samtidig skabe en vigtig forbindelse til Danish Foundation Models (DFM), et nationalt forskningsinitiativ, der udvikler åbne danske sprogmodeller. Ved at gøre modeller, udviklet gennem DFM, direkte tilgængelige i UCloud AI, kan den selv samme infrastruktur understøtte hele processen – fra udvikling og test af nye AI-modeller til at gøre dem tilgængelige for forskning og nye anvendelser.

”Flydende dansk er kun en del af det, vi har brug for fra en sprogmodel. Vi skal også forstå, hvordan den håndterer dansk viden, sociale normer og kulturel kontekst. Udvikling af modeller og praktisk anvendelse skal spille sammen: Vi har brug for adgang til konkurrencedygtige åbne modeller, som vi kan evaluere og integrere i applikationer, mens erfaringerne fra disse applikationer hjælper os med at identificere, hvor modellerne skal forbedres. UCloud AI skaber en vigtig forbindelse mellem disse aktiviteter, så vi både kan undersøge AI systematisk og bygge med teknologien, samtidig med at vi reducerer afhængigheden af kommercielle API-udbydere og får større kontrol over de modeller, vi bruger,” siger Kristoffer Nielbo, professor og leder af Center for Humanities Computing ved Aarhus Universitet samt forskningsleder for Danish Foundation Models.

Fakta om UCloud AI

Udviklet og drevet af: SDU eScience Center. UCloud AI er en del af den infrastruktur, der udbydes af DeiC Interactive HPC-konsortiet, som omfatter SDU, Aarhus Universitet og Aalborg Universitet.

Platform: Bygger på UCloud, som siden 2020 har betjent mere end 25.000 forskere og studerende.

Computerinfrastruktur: Kører på BITTEN i Sønderborg, som er etableret af SDU i samarbejde med Danfoss og Hewlett Packard Enterprise og fungerer som model for, hvordan digital infrastruktur kan integreres med bæredygtige energisystemer. Gennem en aftale med DCAI vil projekter med behov for yderligere skalering eller specialiseret computerkapacitet også kunne få adgang til Gefion, Danmarks nationale AI-supercomputer, gennem UCloud.

Open source og sikkerhed: UCloud er open source under EUPL-licensen og ISO/IEC 27001:2022-certificeret.

Pris: UCloud AI er udviklet til at tilbyde AI-ressourcer til en væsentligt lavere pris end sammenlignelige kommercielle tjenester. Adgangen administreres gennem en transparent, kreditbaseret allokeringsmodel.

Launch website: https://ai.escience.sdu.dk/

For yderligere information kontakt:

Professor Claudio Pica: pica@cp3.sdu.dk
Kategorier
Forskning Interactive HPC Supercomputing UCloud Use-case

Kombinerer AI og satellitdata for at undersøge den øvre atmosfære

For forsker Lotte Ansgaard Thomsen fra Aalborg Universitet har UCloud spillet en central rolle i forskningsprojektet UpperAtmosphere, hvor hun kombinerer kunstig intelligens, satellitdata og fysiske modeller for at få en bedre forståelse af forholdene i den øvre atmosfære.

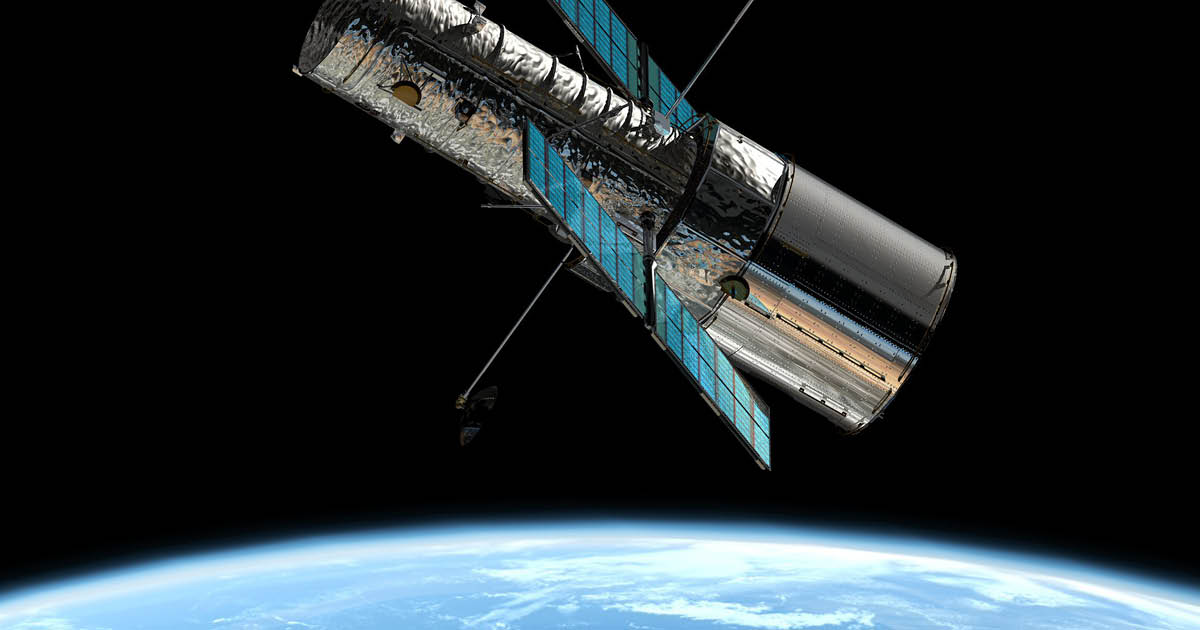
Mange satellitter opererer i denne del af atmosfæren, hvor forholdene hurtigt kan ændre sig på grund af solaktivitet. Traditionelle fysiske modeller er dog ikke altid i stand til at indfange disse hurtige ændringer præcist. For at imødekomme denne udfordring bruger Lotte AI til at lære mønstre på tværs af forskellige datakilder og forbedre den fysiske model.

Lotte Ansgaard Thomsen er lektor ved Institut for Bæredygtighed og Planlægning på Aalborg Universitet. I sit nuværende forskningsprojekt undersøger hun, hvordan AI kan bruges til at forbedre forståelsen af centrale variable i den øvre atmosfære. Det kan bidrage til mere præcise modeller af det rummiljø, hvor satellitter opererer, og give bedre indsigt i de forhold, der kan påvirke satellitters ydeevne, kommunikationssystemer og rumbaseret infrastruktur.

Kombinerer AI og fysiske modeller

En central del af projektet er at kombinere flere forskellige datakilder. Her bidrager satellitmålinger, data om solaktivitet og data om ionosfæren hver især med vigtig information. Når disse datakilder bruges sammen, kan AI-modellen forbedre den fysiske model betydeligt. Ifølge Lotte er netop denne kombination en af de centrale indsigter i projektet indtil videre:

“En vigtig indsigt er, at det virkelig betyder noget at kombinere forskellige datakilder. Satellitmålinger, solaktivitet og ionosfæriske data bidrager hver især med noget unikt. Når jeg bruger dem sammen med AI oven på den fysiske model, bliver modellen markant forbedret.”

UCloud som primær platform

Lotte har brugt UCloud som den primære platform til det beregningsmæssige arbejde i forskningsprojektet. En stor del af arbejdet handler om at træne AI-modeller, hvilket kræver betydelig regnekraft, fordi datasættene er store, og modellerne skal gennem mange iterationer for at finde den rette arkitektur. UCloud er dog ikke kun blevet brugt til de tunge beregninger i slutningen af processen. Platformen har også understøttet udvikling og test af kode undervejs.

“Det giver mig et godt miljø til at opbygge workflowet, afprøve ting og justere undervejs.”

Lotte bruger også UCloud i et andet forskningsprojekt, hvor store sprogmodeller anvendes til at arbejde med miljødata. På tværs af begge projekter har adgangen til regnekraft været afgørende.

“I begge projekter ville vi simpelthen ikke have kunnet udføre arbejdet uden adgang til denne type regnekraft eller et tilsvarende alternativ.”

Adgang til regnekraft gjorde det muligt at få resultater hurtigere

Da Lotte skiftede fra den private sektor til en forskerstilling på universitetet, var hun bekymret for, om hun ville have adgang til tilstrækkelig regnekraft til sin forskning. Derfor var hun glad for at opdage, at UCloud fandtes.

“Det var virkelig rart at opdage, at UCloud fandtes. Adgangen til den mængde ressourcer har været en stor fordel for projektet.”

Med UCloud kunne Lotte få adgang til den nødvendige regnekraft uden først at skulle søge særskilt finansiering. Det gjorde det muligt at komme hurtigere fra udvikling til resultater.

“Hvis jeg ikke havde haft adgang til UCloud eller en anden gratis service og først skulle søge om funding bare for at få adgang til regnekraft, ville det have været umuligt at få resultater så hurtigt.”

En brugervenlig platform til forskning

Ifølge Lotte er en af de største fordele ved UCloud, at platformen har en brugervenlig opsætning til forsknings- og udviklingsarbejde.

“Først og fremmest er UCloud virkelig velegnet til udviklingsarbejde. Det giver mig et godt miljø til at opbygge og teste mit workflow, og i mit forskningsarbejde har jeg oplevet, at platformen har en meget brugervenlig brugerflade.”

Hun har brugt Visual Studio Code på UCloud, der er en kodeeditor til at skrive, teste og udvikle kode. Det giver hende en opsætning, der minder om den, hun bruger lokalt. Det gør det lettere at skifte mellem lokal udvikling og arbejde i skyen. En anden vigtig fordel har været muligheden for at skalere op og få adgang til mere regnekraft, når der er behov for det.

“Det har været meget nemt at skalere op og få mere regnekraft, når jeg har haft brug for det.”

Hurtig support gør en forskel

For Lotte har supporten omkring UCloud også været en vigtig del af oplevelsen. Når man arbejder med komplekse forskningsprojekter, kan tekniske problemer forsinke forskningsprocessen. Hendes erfaring er, at supportteamet har reageret hurtigt, når der er opstået udfordringer.

“Hvis jeg støder på problemer, hjælper teamet næsten med det samme. Det gør en stor forskel, når man arbejder på komplekse projekter.”

Lotte har fået support fra Aalborg Universitets lokale front office, som hjælper forskere med at komme i gang med UCloud og yder support, når der opstår spørgsmål eller tekniske problemer. Alle danske universiteter har et lokalt front office, hvor forskere kan få support.

Samlet set har UCloud givet Lotte adgang til de regneressourcer, det udviklingsmiljø og den support, der er nødvendig for at arbejde med store datasæt, AI-modeller og komplekse forskningsworkflows.

“Jeg synes samlet set, at UCloud er en virkelig god løsning. Når folk taler om behovet for flere europæiske cloud-alternativer, er det den slags løsning, jeg tænker på.”

Dette arbejde er støttet af DeiC National HPC (g.a. DeiC-KU-L1-291125). Læs mere om DeiC’s calls for resources på HPC-platforme: Grants og funding | DeiC.

Kategorier
Applikation Forskning Interactive HPC Kald Supercomputing UCloud

H1-2027: Nationalt HPC kald åbner 21. juli 2026

Du kan nu ansøge om regnetid på UCloud. DeiC har åbnet anden ansøgningsrunde i 2026 for adgang til Danmarks nationale HPC-faciliteter. Hvis dit forskningsprojekt har brug for ekstra regnekraft på UCloud, er det derfor nu, du skal søge.

Ansøgningsrunden åbner kun to gange om året, så dette er en oplagt mulighed for at søge. Forskere og ph.d.-studerende ved danske universiteter kan ansøge.

Vigtige datoer

  • Kald åbner: 21. juli 2026
  • Kald lukker: 1. september 2026
  • Regnetid tilgængelig: 1. januar 2027

Læs mere og ansøg via DeiC

Kategorier
Forskning Supercomputing UCloud Use-case

Dansk sprogmodelprojekt går ind i ny fase med stærkere national regnekraft

Hvordan sikrer man, at fremtidens kunstige intelligens forstår det danske sprog, danske institutioner og danske samfundsforhold – og samtidig håndterer data under rammer, vi selv har kontrol over?


Det spørgsmål er centralt i forskningsprojektet Danish Foundation Models (DFM), hvor Syddansk Universitet, Aarhus Universitet, Københavns Universitet og Alexandra Instituttet samarbejder om at udvikle åbne danske sprogmodeller. Projektet har været i gang i nogen tid, og forskerne har allerede udgivet de første modeller, etableret benchmarks og sat samarbejder i gang med eksterne partnere. Nu står projektet foran næste fase.

Med ny national supercomputerkapacitet, BITTEN, som åbnede i Sønderborg i Maj, hvor forskningsplatformen UCloud er indgangen, kan tempoet i udviklingen stige markant.

Kultur, normer og samfundsforståelse går tabt

Sprogmodeller er på få år blevet strategisk teknologi. De bruges allerede til tekstproduktion, søgninger, til at assistere med beslutningstagning, automatisering og analyse. Men de mest udbredte modeller er udviklet af globale virksomheder og trænet primært på engelsk eller andre udbredte sprog.

Det giver begrænsninger, når modellerne skal bruges i en dansk virkelighed.

Hvis man kigger ned i detaljerne, er mange internationale modeller faktisk dårlige til dansk. Den måde, de formulerer sig på, minder ofte om engelsk oversat til dansk. Det er ikke sådan, vi taler eller skriver, siger professor Peter Schneider-Kamp fra Syddansk Universitet, der står i spidsen for DFM, fra SDU’s side.

Det gælder ikke kun sproget. Det gælder også kultur, normer og samfundsforståelse.

DFM har blandt andet udviklet danske benchmarks, der tester modeller på dansk kulturviden. Her klarer selv de største internationale modeller sig ofte svagt.

De mangler indsigt i, hvordan Danmark fungerer – i vores litteratur, vores offentlige sektor, vores sundhedsvæsen og vores kulturelle referencerammer, forklarer Schneider-Kamp.

Danmark kan ikke stå udenfor

Udviklingen inden for AI går så hurtigt, at adgang til egne kompetencer og egen infrastruktur bliver stadig vigtigere. Ifølge Schneider-Kamp er det risikabelt at antage, at andre lande fortsat vil levere de tjenester og modeller, Europa har brug for, i al fremtid.

Vi kan ikke bare regne med, at amerikanske eller kinesiske virksomheder stiller de rigtige løsninger til rådighed for os for evigt. Vi er nødt til selv at være med i udviklingen, siger han.

Her handler det ikke om at kopiere Silicon Valley i skala, men om at kunne udvikle målrettede løsninger til danske behov – og gøre det på et gennemsigtigt og ansvarligt grundlag.

Vi vil gerne have modeller, hvor vi ved, hvad de er trænet på, som overholder GDPR og AI-forordningen, og som har styr på dansk sprog, dansk kultur og danske normer, siger han.

UCloud er rygraden

Bag projektet ligger en mindre synlig, men afgørende del af historien: forskningsinfrastrukturen.

DFM udvikles i høj grad ved brugen af UCloud, den nationale platform for interaktiv højtydende computing, udviklet af SDU eScience Center i samarbejde med partnere. Her får forskere adgang til lagerkapacitet, GPU’er, software og samarbejdsværktøjer i ét samlet miljø.

For Peter Schneider-Kamp er UCloud helt central.

UCloud er vores sikre miljø, hvor vi udvikler modeller, træner modeller, lagrer data og evaluerer dem. Det er meget centralt i det, vi laver, siger han.

Sikkerhedsperspektivet er væsentligt. Når forskere arbejder med store datamængder – og i nogle projekter også følsomme data – er det afgørende, at data kan håndteres i et kontrolleret miljø.

Hvis vi får nye datasæt fra for eksempel biblioteker, medier eller andre kilder, kan vi opbevare dem sikkert, arbejde direkte på dem og bevare kontrollen over dataene, siger han.

Alternativet vil ofte være mere tunge og fragmenterede løsninger, hvor data skal flyttes mellem systemer og lande.

Ny national supercomputer BITTEN

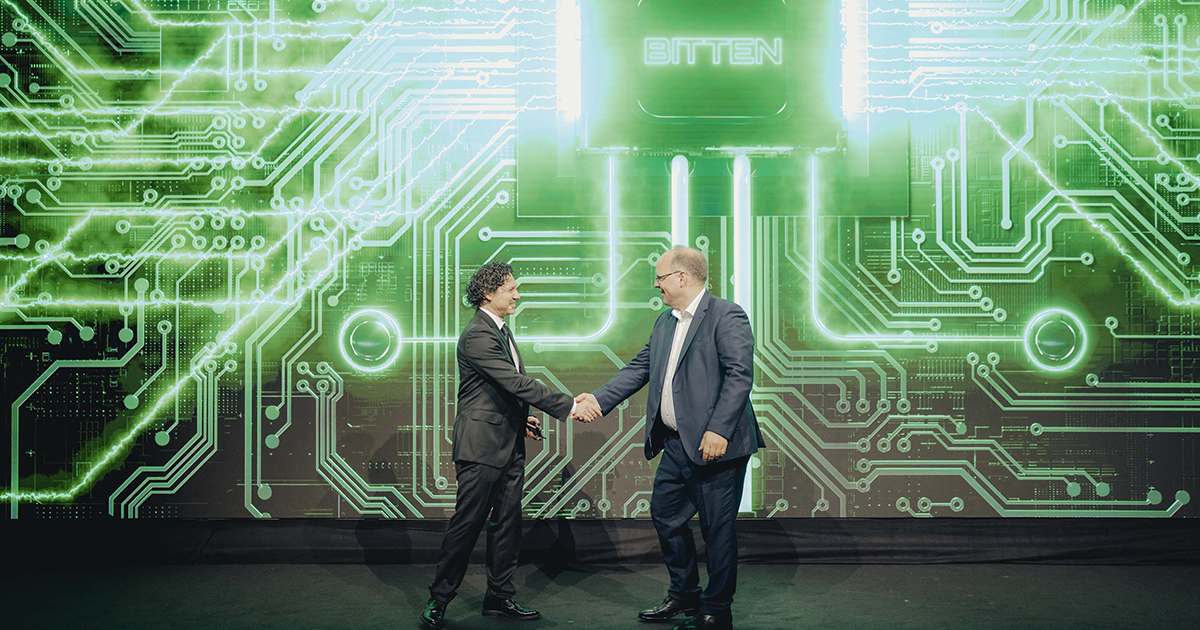
Den 5. maj 2026 blev en ny national supercomputer indviet i Sønderborg: BITTEN. Anlægget er etableret af Syddansk Universitet i samarbejde med Danfoss og Hewlett Packard Enterprise (HPE) og er en del af den danske forskningsinfrastruktur inden for kunstig intelligens, avancerede beregninger og datatung forskning.

Supercomputeren stilles til rådighed gennem UCloud, så forskere og studerende på universiteter i hele landet kan få adgang via eksisterende systemer og arbejdsgange.

Samarbejdet forener SDU’s erfaring med forskningsinfrastruktur, Danfoss’ kompetencer inden for energieffektive køle- og varmeløsninger samt HPE’s ekspertise i supercomputing og datacenterteknologi.

Anlægget er samtidig udviklet med fokus på energieffektiv drift og genanvendelse af overskudsvarme.

Kapacitetsmangel bremser forskning

For AI-forskning er adgang til regnekraft ikke et luksusproblem, men en forudsætning.

Tidligere oplevede DFM-gruppen jævnligt flaskehalse, når modeller skulle trænes.

Nogle gange har vi oplevet at vente to, tre, fire eller fem dage på at få fat i en GPU. Imens sidder ph.d.-studerende og postdocs klar med idéer og kode, men bliv bremset af manglende ressourcer, siger Peter Schneider-Kamp.

Det er netop her, den nye kapacitet kan gøre en forskel.

Mere regnekraft betyder hurtigere eksperimenter, større modeller, flere iterationer og kortere vej fra idé til resultat.

Vi håber, det vil give os hurtigere omsætning fra idéer til forskningsresultater og konkrete use cases! Vi glæder os helt vildt til at få adgang til de de langt flere GPU’er, siger han.

Mere end teknologi

DFM handler derfor om mere end software og hardware. Projektet illustrerer, hvordan forskning, digital suverænitet, datasikkerhed og innovation hænger tæt sammen.

Hvis Danmark vil bruge AI i sundhedsvæsenet, den offentlige sektor, uddannelserne og erhvervslivet, kræver det løsninger, man kan forstå, tilpasse og have tillid til.

Med UCloud som arbejdende rygrad og ny national supercomputerkapacitet BITTEN, står Danish Foundation Models nu et sted, hvor arbejdet kan bevæge sig fra lovende opbygning til bredere anvendelse.

Spørgsmålet er ikke længere kun, om Danmark kan udvikle egne sprogmodeller.

Spørgsmålet er, om vi har råd til at lade være.

Læs mere om DFM projektet her

Kategorier
Forskning Interactive HPC Supercomputing UCloud Use-case

Hvordan UCloud understøttede omfattende forskning i tidsanvendelse, forbrug og socioøkonomiske forskelle 

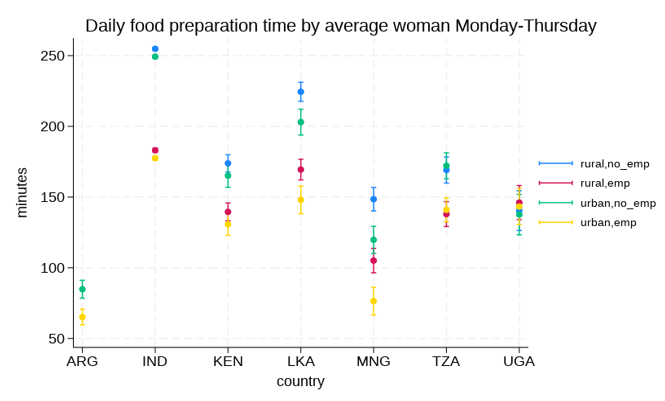
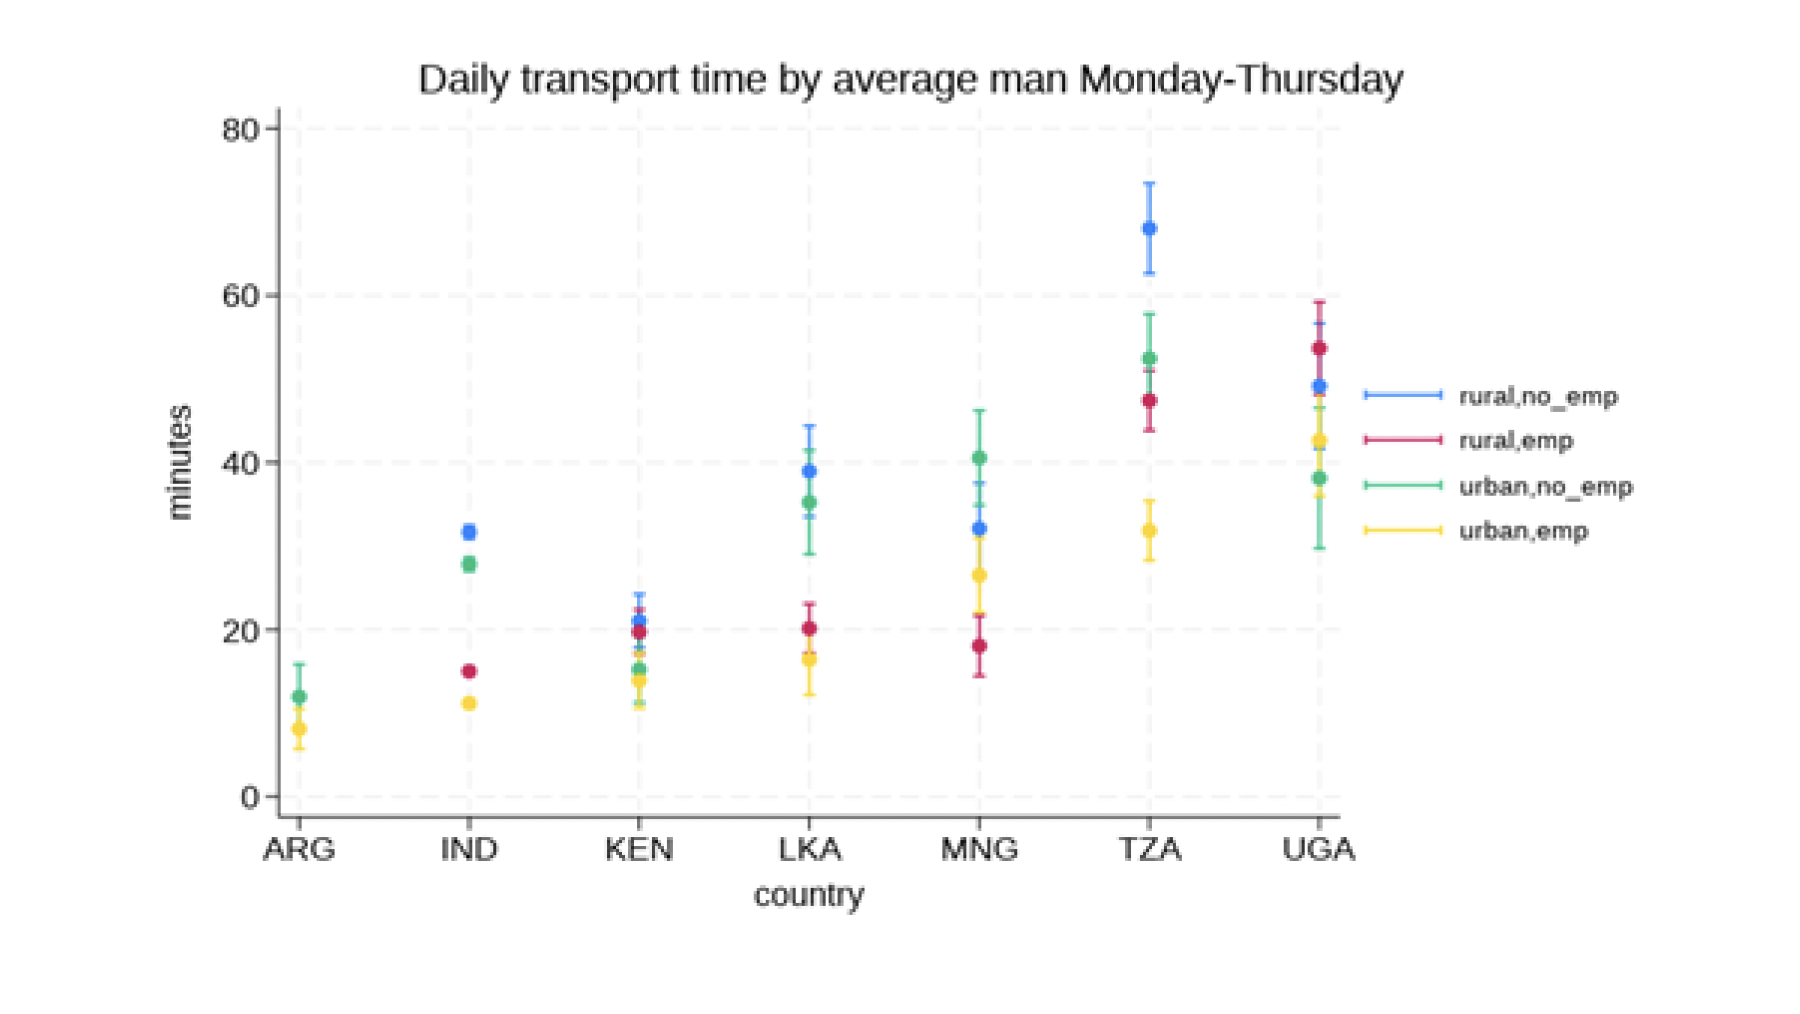
UCloud spillede en vigtig rolle i Sofia Topcu Madsens forskning ved at gøre det muligt for hende at analysere store mængder tidsanvendelses- og forbrugsdata fra syv lande hurtigere og mere effektivt. På den måde kunne hun få ny indsigt i, hvordan mennesker bruger tid og penge i hverdagen.

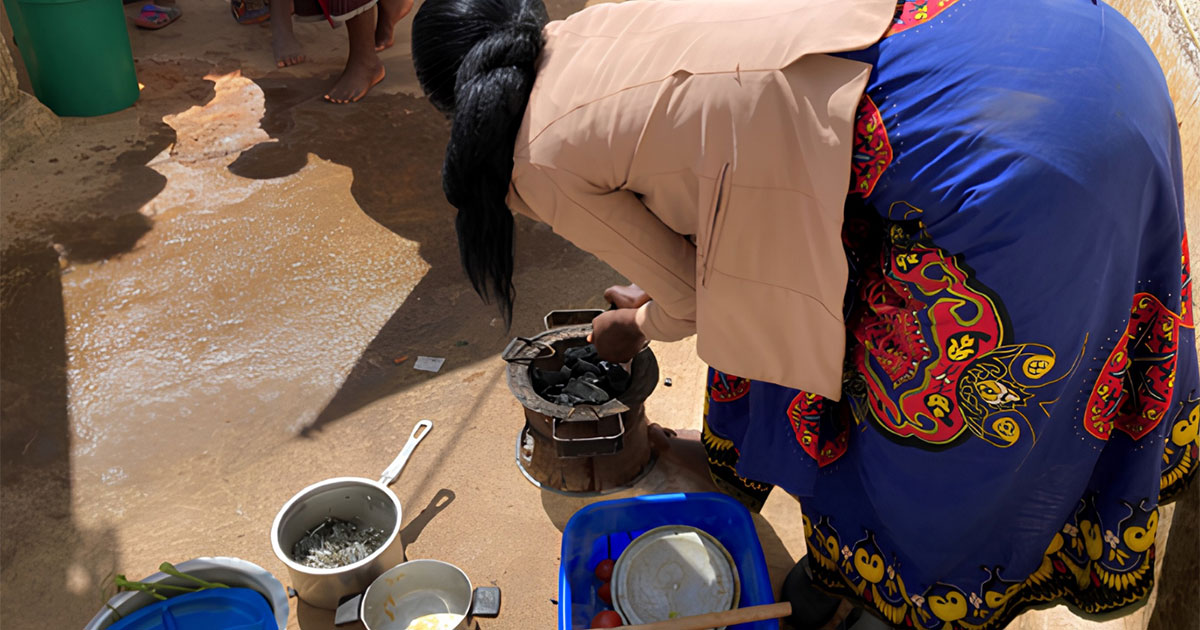
Sofia Topcu Madsen er tidligere ph.d.-stipendiat ved Aalborg Universitet, Institut for Bæredygtighed og Planlægning. Som en del af sit ph.d.-projekt, Getting the Data Right, undersøger hun, hvordan mennesker i syv lav- og mellemindkomstlande bruger tid og penge på forskellige hverdagsaktiviteter – og hvordan socioøkonomiske faktorer påvirker, hvad mennesker har mulighed for at gøre.

Projektet omfatter Uganda, Kenya, Tanzania, Indien, Sri Lanka, Argentina og Mongoliet. Med udgangspunkt i omfattende tidsanvendelses- og forbrugsdata analyserer Sofia hverdagsaktiviteter som transport og husholdningsarbejde. Her undersøger hun blandt andet, hvordan tid og penge brugt på forskellige aktiviteter varierer på tværs af socioøkonomiske grupper.

Store datasæt 

Sofias analyser bygger på forskellige typer detaljerede data. Et eksempel er tidsanvendelsesdagbøger, hvor deltagerne registrerer, hvad de laver i løbet af dagen i intervaller på 10 minutter. For nogle lande er datasættene meget store. Alene i det indiske datasæt arbejder Sofia med omkring en halv million observationer.

Det gør beregningsarbejdet krævende. I begyndelsen forsøgte Sofia at køre analyserne på sin egen computer, men datasættene var for store, og analyserne tog for lang tid. 

“På min egen computer kunne analyserne tage flere dage at køre. Med UCloud blev det meget hurtigere og mere overskueligt,” forklarer Sofia.

UCloud gav hende adgang til mere computerkraft, hvilket gjorde det muligt at køre store analyser mere effektivt og gentage dem, når der var behov for rettelser eller justeringer. Det blev vigtigt gennem hele projektet, da selv små ændringer i dataopsætningen eller modelspecifikationen kunne kræve, at analyserne blev kørt igen.

“UCloud har været en kæmpe hjælp. Jeg tror ikke, jeg ville have kunnet gennemføre denne del af projektet på samme måde uden adgang til det,” siger Sofia.

Brug af Stata og R på UCloud 

Til analyserne brugte Sofia Stata og R på UCloud. Stata og R er værktøjer, som forskere bruger til at arbejde med data og udføre statistiske analyser. 

I Sofias projekt blev værktøjerne brugt til at køre regressionsanalyser, hvor hun undersøger, hvordan forskellige faktorer kan hænge sammen – for eksempel hvordan uddannelse, indkomst eller køn kan være relateret til, hvor meget tid og hvor mange penge mennesker bruger på transport, husholdningsarbejde eller andre hverdagsaktiviteter. 

Hun brugte SUR-metoder, som gør det muligt at køre flere relaterede analyser på samme tid. Det var relevant, fordi projektet undersøger aktiviteter på tværs af et helt døgn, hvor tid brugt på én aktivitet kan hænge sammen med tid brugt på en anden. På samme måde betyder penge brugt på produkter, der understøtter én aktivitet, at der er færre penge til andre produkter. 

At køre flere analyser samtidigt på store datasæt kræver meget computerkraft og ville have været meget tidskrævende på en almindelig computer. Ved at bruge UCloud kunne Sofia køre analyserne hurtigere og mere effektivt, hvilket sparede hende for meget tid. 

Bidrag til forskning i bæredygtig udvikling  

Sofias forskning knytter sig til FN’s verdensmål ved at undersøge, hvordan hverdagsaktiviteter kan bruges som indikatorer for bredere sociale og økonomiske forhold. 

Hvordan mennesker bruger deres tid, kan fortælle os noget vigtigt om hverdagsliv, ulighed og muligheder. For eksempel kan et samlet perspektiv på tid og penge brugt på transport, husholdningsarbejde eller fritid vise, hvordan ressourcer, ansvar og muligheder er fordelt på tværs af forskellige befolkningsgrupper. 

“Tid kan også forstås som en ressource. Når vi ser på, hvordan mennesker bruger deres tid, får vi en anden måde at forstå fattigdom, ulighed og bæredygtig udvikling på,” forklarer Sofia. 

En brugervenlig platform  

Sofia beskriver UCloud som en platform, der er nem at tilgå og anvende, særligt da arbejdsgangen først var på plads. Hun fremhæver også supporten som en vigtig del af oplevelsen. 

“Supporten har været meget effektiv. Jeg har fået hurtige svar på mine spørgsmål, og det har været en stor hjælp,” siger hun. 

Sofia fik support fra Aalborg Universitets lokale Front Office. Hvert dansk universitet har sit eget Front Office, hvor forskere kan få hjælp til adgang, brug og spørgsmål relateret til UCloud. 

Vil bruge UCloud igen  


Sofia er i dag ansat ved Københavns Universitet, Institut for Fødevare- og Ressourceøkonomi, og hun kan se sig selv bruge UCloud igen i fremtidige forskningsprojekter. 

“Jeg ville helt klart bruge UCloud igen,” siger hun. 

Fordi UCloud er tilgængelig for forskere tilknyttet danske universiteter, kan Sofia også fortsætte med at bruge platformen i fremtidige forskningsprojekter ved Københavns Universitet. 

Kategorier
Forskning Interactive HPC Supercomputing

Ny national supercomputerkapacitet tilgængelig via UCloud 

Et nyindviet supercomputeranlæg udvider adgangen til avancerede beregningsressourcer for forskere og studerende i hele Danmark via UCloud.

Et nyt supercomputeranlæg er blevet indviet på Alsion i Sønderborg og markerer en vigtig udvidelse af Danmarks digitale forskningsinfrastruktur. Systemet, der har fået navnet Bitten, skal understøtte forskning og undervisning inden for blandt andet kunstig intelligens, dataanalyse og avancerede beregninger – og bliver tilgængeligt for brugere over hele landet gennem UCloud.

Ved at tilbyde adgang via UCloud bliver systemet tilgængeligt i et velkendt miljø, som allerede anvendes af tusindvis af forskere og studerende. Brugerne kan få adgang til avancerede beregningsressourcer direkte gennem en browserbaseret grænseflade, hvor værktøjer og applikationer vælges på samme måde som i en app store – uden behov for at håndtere eller forstå den underliggende infrastruktur. Det sænker adgangsbarrieren markant og gør højtydende computing tilgængelig ikke kun for specialister, men på tværs af fagområder.

Den nye løsning forenkler samtidig brugeroplevelsen. Infrastruktur, som tidligere var fordelt på flere lokationer, er nu samlet i ét datacenter, hvilket gør det lettere at navigere i og arbejde med beregningsressourcerne.

Udvider adgangen til avanceret computing 

Tilføjelsen af ny supercomputerkapacitet øger både, hvad forskere kan gøre – og hvem der kan gøre det. Ved at fjerne tekniske og praktiske barrierer gør platformen det muligt for flere forskere og studerende at arbejde med store datamængder, avancerede modeller og beregningsmetoder. Det accelererer vejen fra idé til indsigt og fra forskning til anvendelse i praksis.

Lige så vigtigt er det, at dette sker inden for en dansk digital infrastruktur, hvor data, software og beregninger forbliver under national kontrol. Efterhånden som afhængigheden af store datamængder og kunstig intelligens vokser, bliver spørgsmål om datastyring, sikkerhed og kontrol stadig mere centrale – ikke kun fra et teknisk perspektiv, men også som en strategisk prioritet for forskning og innovation.

”Adgang til regnekraft er kun en del af ligningen,” siger professor Claudio Pica, direktør for SDU eScience Center og repræsentant for konsortiet bag UCloud. ”Det er mindst lige så vigtigt, at forskere kan arbejde i et betroet miljø, hvor data og arbejdsgange forbliver under national kontrol. UCloud gør det muligt at kombinere avanceret computing med netop den grad af tillid og gennemsigtighed.” 

En fælles platform for forskning og innovation

UCloud anvendes allerede bredt på danske universiteter og understøtter en lang række fagområder og anvendelser. Platformen har nu mere end 23.000 brugere på tværs af forskningsfelter. Med tilføjelsen af nye højtydende ressourcer fortsætter platformen med at udvikle sig for at imødekomme de voksende behov inden for forskning og uddannelse.

Platformen understøtter også startups og spinout-virksomheder ved at give adgang til avanceret AI og dataanalyse, hvilket forbedrer mulighederne for at udvikle, teste og skalere nye løsninger. På den måde bidrager infrastrukturen ikke kun til forskning, men også bredere til innovation og konkurrenceevne.

UCloud udvikles og drives i tæt samarbejde mellem partnerne i Interactive HPC Konsortiet, som består af Syddansk Universitet, Aarhus Universitet og Aalborg Universitet. Det afspejler en langsigtet fælles indsats blandt danske universiteter for at opbygge en delt digital forskningsinfrastruktur.

Del af en bredere national indsats

Det nye supercomputeranlæg, Bitten, er en del af Danmarks nationale forskningsinfrastruktur og afspejler et løbende samarbejde mellem universiteter, industri og teknologileverandører. Adgangen via UCloud spiller en central rolle i at sikre, at denne investering kommer en bred brugergruppe i hele landet til gavn.

Anlægget er samtidig designet med fokus på energieffektivitet. Systemet er udviklet i samarbejde mellem SDU, Danfoss og HPE og anvender avanceret væskekøling med fuld varmegenvinding, så overskudsvarme kan genbruges i det lokale fjernvarmesystem. Dermed bliver anlægget et eksempel på, hvordan digital infrastruktur aktivt kan understøtte energisystemet – ved at ændre datacentre fra rene energiforbrugere til integrerede og værdiskabende dele af lokal infrastruktur.

Kategorier
Applikation Forskning Interactive HPC Supercomputing

Introducing RAGFlow: Enabling Smarter Research with AI-Powered Search

A new open-source application is now available on UCloud, designed for students, researchers, and educators working with complex data and artificial intelligence. RAGFlow – short for Retrieval-Augmented Generation – combines powerful language models with your own academic materials, offering an intelligent way to search, explore, and interact with content.

Whether you’re conducting a literature review, developing a teaching assistant, or building a domain-specific chatbot, RAGFlow provides an intuitive pipeline that transforms unstructured documents into a searchable, AI-ready knowledge base. But RAGFlow is more than just question-answering. It supports the creation of custom workflows and intelligent agents, enabling advanced interactions, data processing, and tool integration – all within a flexible and transparent environment.

What can you do with RAGFlow?

RAGFlow helps large language models (LLMs) generate accurate answers based on real data – not just pre-trained knowledge. It’s built to close the gap between raw academic material and useful insight.

RAGFlow is designed with both beginners and advanced users in mind. At its simplest, you can just upload documents and start asking questions. The interface guides you through the basics, so you can get useful results straight away.

As your needs grow, you can delve deeper into advanced features such as custom chunking, retrieval tests, datasets, and programmable workflows. Comprehensive documentation and tutorials are available, allowing you to learn at your own pace and expand your use of the platform over time.

Key Features:
  • Data Ingestion & Chunking:
    Upload PDFs, text files, webpages and more. RAGFlow automatically breaks them into manageable parts.
  • Embedding & Indexing:
    These chunks are converted into vector representations so they can be searched by meaning, not just keywords.
  • Smart Retrieval:
    When you ask a question, the system finds the most relevant information.
  • Contextual Generation:
    An LLM uses this context to generate well-informed responses.
  • Cited Sources:
    All answers come with grounded citations, showing where the information came from — supporting transparency and academic rigour.

This process improves the quality of responses and significantly reduces the risk of hallucinated or misleading answers.

From Search to Workflow: Introducing Agents

Beyond document search, RAGFlow also allows you to build and customise your own AI-powered agents. These agents can search, analyse, and use tools on your behalf – forming a pipeline tailored to your specific research needs.

So, what is an agent?

Think of an agent as a specialised AI assistant. You might create one to retrieve data from a source, another to analyse it, and a third to generate a written summary or report. These agents can be chained together into a programmable pipeline – a step-by-step flow where each agent passes its output to the next.

For example, you could build a research assistant that:

  • Searches for academic papers on a topic
  • Extracts and summarises the most relevant findings
  • Runs basic statistical analysis
  • Outputs the results as a draft report

Unlike typical ‘black-box’ AI tools, which conceal their inner workings, RAGFlow provides full transparency, allowing you to understand exactly how your AI operates. You can inspect, adjust, and understand every stage – from document chunking to embedding, retrieval, and agent reasoning. It’s a flexible and reproducible platform where your agents can be saved, re-run, or even shared with colleagues.

Why use RAGFlow on UCloud?

RAGFlow is available directly on UCloud. This offers several key advantages:

  • Academic Use Cases:
    Build assistants for teaching, research discovery, or even entire knowledge bases for your institute or research centre.
  • No Installation Required:
    Launch RAGFlow on UCloud with everything preconfigured and ready to use.
  • Flexible AI Model Support:
    Choose from models hosted on Hugging Face, Ollama, or take advantage of GPU-accelerated inference with vLLM – all accessible via an API key.
  • Easy Document Management:
    Upload and manage a wide range of formats, including PDFs, scanned documents, spreadsheets, and HTML.
Learn more 

Guides and technical details:
RAGFlow Guide
RAGFlow documentation on UCloud

A recorded tutorial will also be available shortly. Sign up for the newsletter to receive updates on this and other Interactive HPC news.

Kategorier
Forskning Interactive HPC Supercomputing UCloud Undervisning Use-case

UCloud giver studerende adgang til avanceret NLP i undervisningen 

På kandidatuddannelsen i Cognitive Science ved Aarhus Universitet spiller UCloud en central rolle i undervisningen i Natural Language Processing (NLP). For underviser og ph.d.-studerende Mina Almasi er platformen afgørende for, at de studerende kan arbejde praktisk med komplekse modeller – uanset deres egen computers begrænsninger.

Fra teori til hands-on læring 

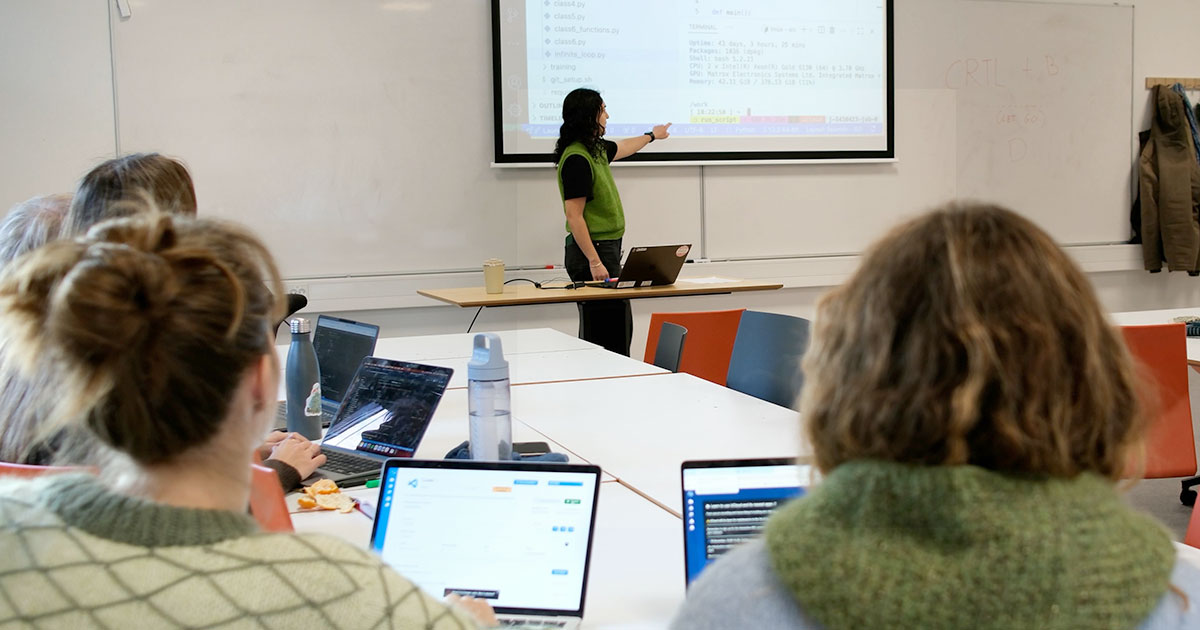
I et hvidt undervisningslokale i Nobelparken står Mina foran 15 studerende. På skærmen bag hende står Python-koden i rette, symmetriske linjer, mens hun forklarer, hvilke kodebiblioteker de studerende skal tilgå.

I undervisningen bruger hun Coder Python-applikationen i UCloud, fordi kurset bygger på Python-programmering. Men valget af platform handler ikke kun om software – det handler om at give de studerende mulighed for at omsætte teori til praksis. 

Tidligere foregik NLP-undervisningen, ifølge Mina, ofte på et mere teoretisk niveau, fordi der manglede adgang til både modeller og computerkraft til at afprøve teorierne i praksis. Især når det gjaldt de store sprogmodeller. Med UCloud kan de studerende nu arbejde direkte med sprogmodeller (LLMs) og bruge kraftfulde GPU’er og CPU’er. Det betyder, at de selv kan teste teorierne og eksperimentere hands-on med de værktøjer, de lærer om. 

”Vi underviser stadig i teorien, men nu kan vi også få de studerende til at bruge værktøjerne i praksis. De kan kode selv og få indsigt i, hvordan en stor sprogmodel fungerer ved at arbejde direkte med den gennem UCloud,” forklarer hun. 

Et standardiseret setup, der demokratiserer klasseværelset 

En anden fordel ved at bruge UCloud i NLP-undervisningen er, at platformen sikrer lige adgang for alle studerende, uanset hvilken computer de har. 

”Der er en form for demokratisering af klasseværelset, fordi man ikke behøver den nyeste computer. Man kan bruge en fem år gammel maskine til at køre meget tunge opgaver, som de nyeste værktøjer inden for Natural Language Processing kræver,” forklarer hun. 

Det standardiserede setup gør samtidig undervisningen mere flydende. Alle studerende arbejder med samme standardkonfiguration i UCloud, så problemer, der opstår, er ens for alle. Det skaber et fællesskab omkring løsningerne, fordi udfordringerne kan adresseres i fællesskab, frem for at enkelte studerende må håndtere dem alene. Som Mina udtaler: 

”I stedet for at stoppe op i undervisningen for at løse individuelle problemer, bliver problemerne kollektive og en mulighed for læring for alle. Hvis vi har en softwareudfordring, for eksempel en Python-biblioteksversion, der er forældet eller ikke kompatibel, påvirker det alle, og vi kan løse det sammen.” 

En forberedelse til arbejdslivet 

For Mina hjælper brugen af UCloud også med at forberede de studerende på den virkelighed, der venter dem, når de er færdige. Mange af de studerende, der går videre til IT-stillinger, vil, ifølge hende, sandsynligvis bruge cloud computing-platforme og ikke kode på deres lokale computere. På den måde bliver undervisningen en direkte forberedelse på fremtidige arbejdsopgaver og giver de studerende erfaring med de teknologier, de kommer til at møde i praksis. 

Råd til andre undervisere 

Mina har brugt UCloud siden sin bachelor og oplever, at platformen gør undervisningen både smidigere og mere engagerende. 

”Jeg anbefaler at andre undervisere gør brug af platformen. Man skal bare gå i gang, men spørg gerne kolleger til råds om, hvordan de bruger det. Få lidt inspiration, for UCloud er et fantastisk værktøj. Det kan rigtig mange ting, men som med andre systemer kan det være lidt overvældende i starten, så det er en god idé at få lidt råd med på vejen, før du går i gang.” 

Kategorier
Forskning Interactive HPC Kald Supercomputing UCloud

H2-2026 Nationalt HPC kald er åbent

Du kan nu søge om regnetid på UCloud. DeiC har åbnet den første ansøgningsrunde i 2026 for adgang til Danmarks nationale HPC-faciliteter – og Interactive HPC – UCloud er en del af denne runde.

Hvis dit forskningsprojekt har behov for ekstra regneressourcer på UCloud, er det nu, du skal søge. Der åbnes kun for disse ansøgningsrunder to gange om året, så dette er en oplagt mulighed for at indsende en ansøgning i denne runde. Forskere (og ph.d.-studerende) ved danske universiteter kan ansøge.

Vigtige datoer

  • Ansøgningsrunde åbner: 13. januar 2026
  • Ansøgningsfrist: 10. marts 2026
  • Ressourcer til rådighed fra: 1. juli 2026

Læs mere og ansøg via DeiC

Kategorier
Applikation Forskning Interactive HPC Supercomputing Vejledning Workshop

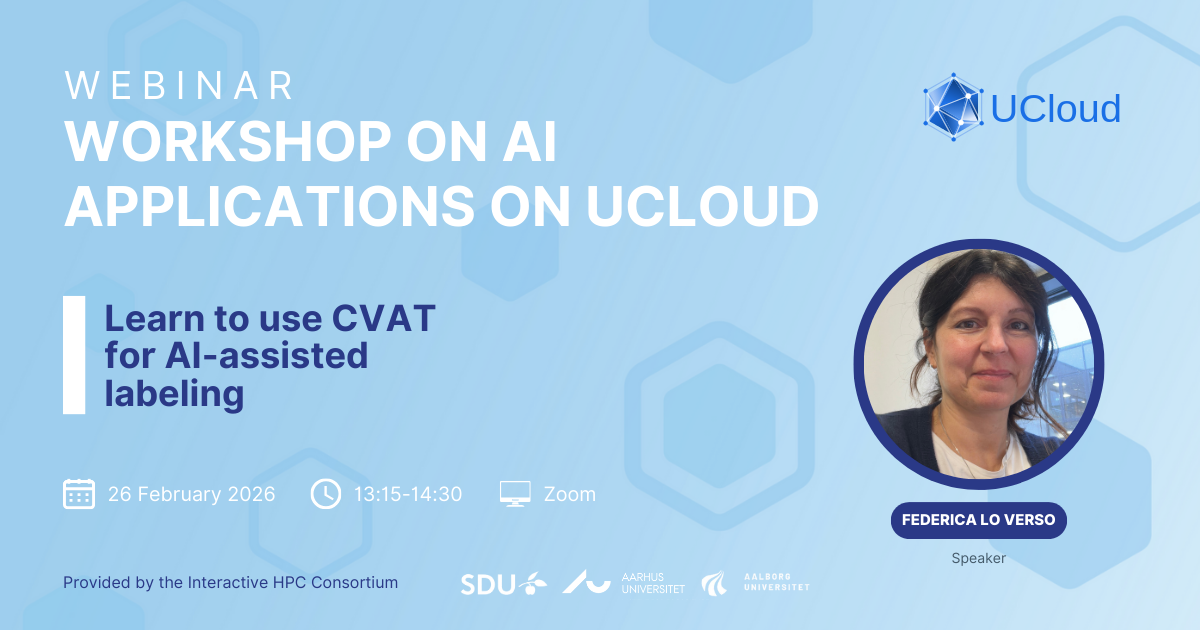
Workshop 26/2: CVAT – AI-Assisted Labeling

Date: 26. februar 2026

Time: 13:15 to 14:30 CET

Location: Online via Zoom

CVAT (Computer Vision Annotation Tool) er et interaktivt værktøj til annotering af video- og billeddata, udviklet til at lette annoteringsarbejdet og accelerere opbygningen af datasæt af høj kvalitet til computer vision-opgaver. CVAT er tilgængeligt på UCloud-platformen via Application Store.

Webinaret vil vise, hvordan man anvender CVAT på UCloud til at:
  • mærke og annotere data ved hjælp af AI- og OpenCV-værktøjer, herunder:
    • brug af cvat-cli
    • kørsel af indbyggede modeller til detektion og automatisk annotering
    • anvendelse af GPU’er sammen med indbyggede modeller for hurtigere annotering
    • tilføjelse af brugerdefinerede modeller (f.eks. YOLO)
  • effektivt at håndtere store visuelle datasæt med MinIO:
    • give CVAT direkte adgang til at hente billeder fra dine UCloud MinIO-buckets til annotering og eksportere annoterede data tilbage igen, hvilket reducerer manuelle importer/eksporter og sikrer datatilgængelighed.

Ved at bruge UCloud kan brugere etablere fuldt reproducerbare og sikre workflows, der udnytter højtydende computerressourcer. Disse funktioner er ofte nødvendige ved arbejde med store datasæt og præcise computer vision-opgaver.

Målgruppe:
Forskere på tværs af alle institutter, særligt dem med behov for højpræcis datamærkning, samt forskere med interesse for AI.

Teknisk niveau:
Grundlæggende til mellemniveau

Sign up for the CVAT workshop